Автор: Marko · 4 хв читання
Чому AI-проєкти провалюються і який етап пропускають
Демо працює вже за вечір. Чат-бот відповідає клієнтам, агент складає звіт, команда в захваті. Минає два місяці, і проєкт тихо зникає з порядку денного. Знайомо? Так закінчується більшість AI-проєктів, і рідко через саму модель.
Нижче розбираємо, що кажуть дослідження, звідки взялась гучна цифра 95% і на якому етапі проєкти ламаються.
Чому більшість AI-проєктів провалюються?
Більшість AI-проєктів провалюються, бо команда стрибає до автоматизації раніше, ніж AI знає контекст бізнесу і ніж зрозуміло, що вважати результатом. Дослідження називають одні й ті самі причини: нечітко поставлена задача, погані дані, неясна цінність. Модель рідко буває головною проблемою. Проблема в тому, на що вона спирається.
За оцінками, які наводить RAND, понад 80% AI-проєктів не досягають мети. Це вдвічі частіше, ніж у звичайних IT-проєктів без AI. Дослідники RAND опитали 65 досвідчених дата-сайєнтистів та інженерів, і першою причиною провалу назвали таку: замовник неправильно розуміє, яку проблему має розв'язати AI, або не може її пояснити.
Gartner у 2024 році прогнозував, що щонайменше 30% проєктів генеративного AI покинуть після пілоту до кінця 2025 року. Причини: погана якість даних, слабкий контроль ризиків, зростання витрат і неясна бізнес-цінність.
Чи правда, що 95% AI-проєктів провалюються?
Цифра 95% походить зі звіту MIT NANDA «The GenAI Divide» 2025 року, і міряє вона вужче, ніж звучить. За переказом Fortune, 95% компаній у вибірці дослідників не побачили вимірного впливу генеративного AI на прибуток. Це висновок про конкретну вибірку і про гроші. На всі AI-проєкти у світі його переносити не варто.
Сам звіт MIT поширюється за запитом, тому тут ми спираємось на переказ Fortune. Варто знати і ширшу картину. Цифри в різних джерелах коливаються від 30% до 95%, бо міряють різне: пілоти, які покинули, проєкти, що не досягли мети, компанії без прибутку від AI. Спільне в них одне: провал трапляється частіше за успіх, і причини майже завжди ті самі.
Причини провалу по чотирьох етапах
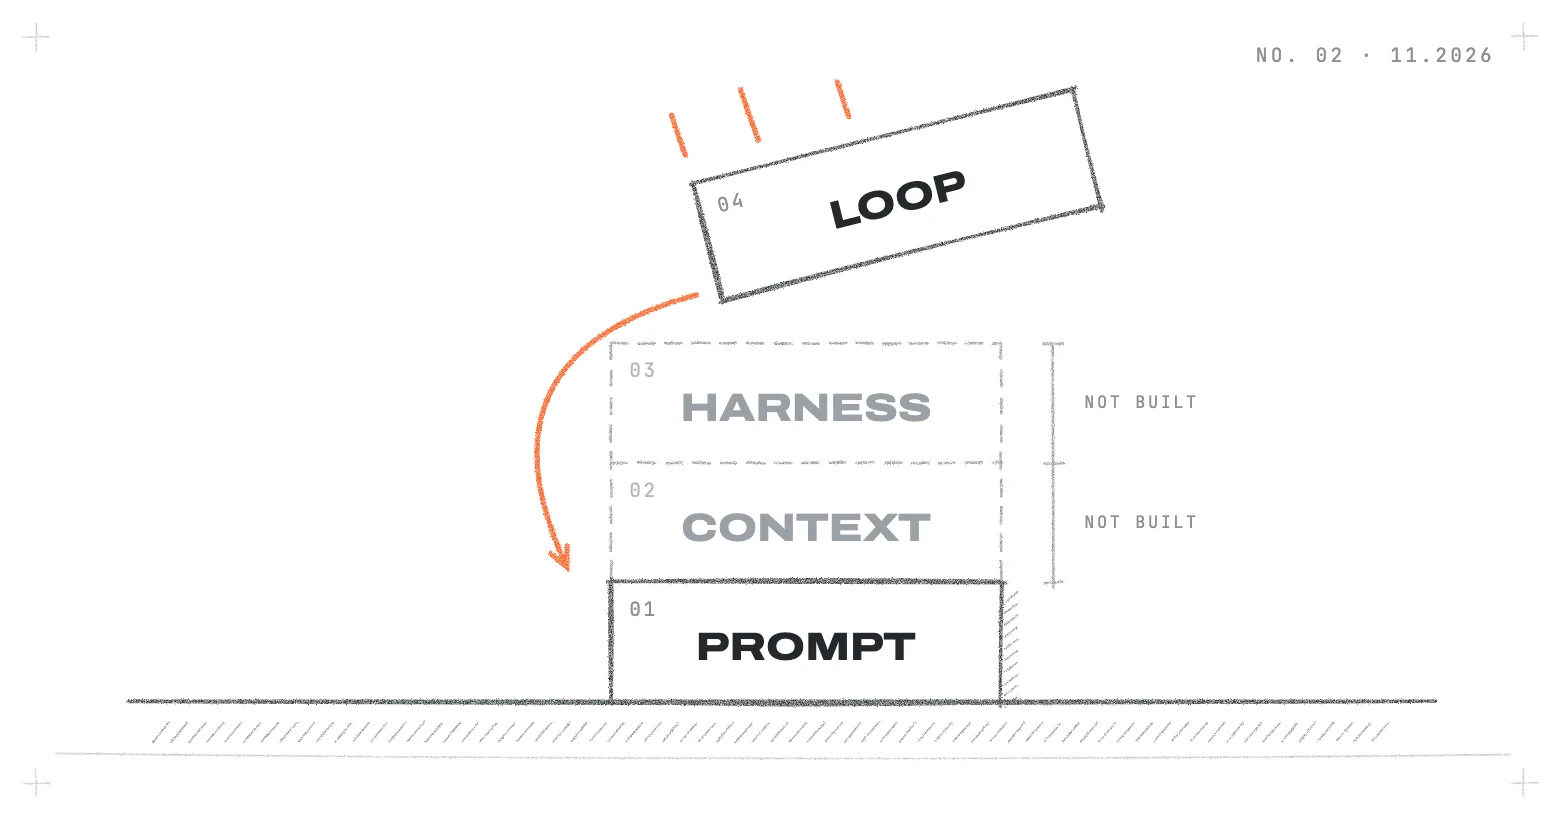
У статті про модель зрілості AI ми описали чотири етапи: Prompt, Context, Harness і Loop. Кожен наступний тримається на попередньому. Якщо покласти причини з досліджень поруч з етапами, майже кожна з них означає, що команда пропустила якийсь етап.
| Етап | Що мало з'явитись | Як провал звучить у дослідженнях | Ознака у вас |
|---|---|---|---|
| Prompt | спільні правила роботи з AI | наше спостереження: пілот тримається на одній людині | результат є лише в того, хто запустив пілот |
| Context | одна база знань бізнесу | погана якість даних (Gartner), бракує даних (RAND) | AI щоразу треба пояснювати, хто ви і як у вас заведено |
| Harness | критерій «зроблено» і перевірка | неясна цінність (Gartner), неправильно зрозуміла задача (RAND) | ніхто не може сказати, чи пілот вдався |
| Loop | регулярна робота без ручних нагадувань | зростання витрат і неясна цінність (Gartner) | автоматизація множить помилки швидше, ніж їх помічають |
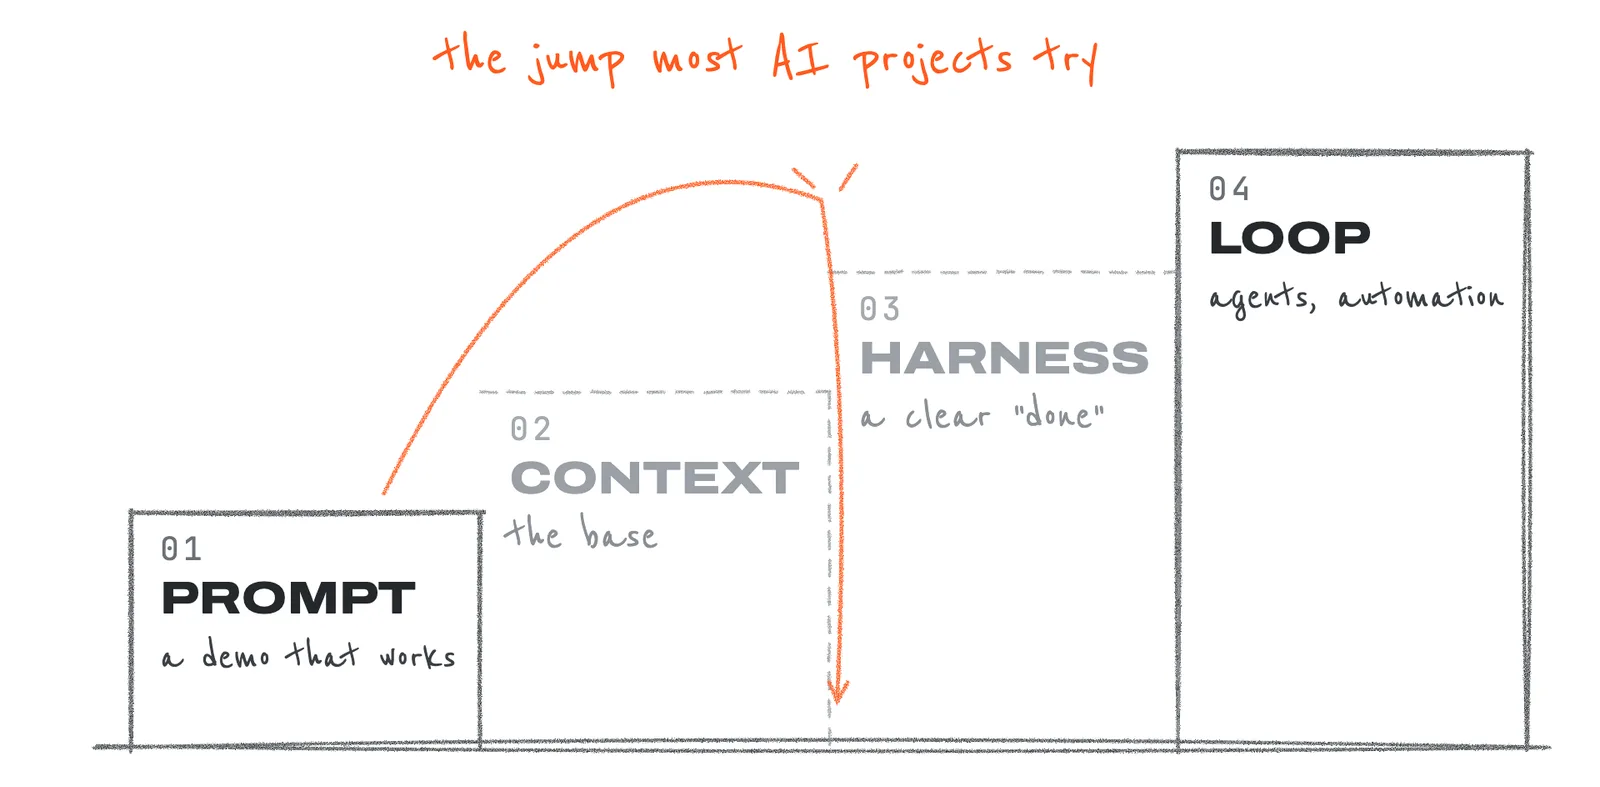
Найчастіше пропускають Context і Harness. Вони найменш помітні: у них немає ефектного демо, лише записані домовленості й чіткі критерії. Зате саме вони вирішують, чи пілот переживе зустріч зі справжньою роботою. Context означає базу знань для AI, з якої працюють і команда, і AI. Harness означає, що в кожної задачі є критерії приймання і результат перевіряють за ними.
Стрибок одразу на четвертий етап коштує найдорожче. За прогнозом Gartner, понад 40% проєктів з AI-агентами скасують до кінця 2027 року. Агент без бази знань працює наосліп, а агент без перевірки результату просто швидше помиляється.
Чому AI здається простішим, ніж є
На старті AI здається всесильним. Прототип збирається за вечір, і людина одразу планує ще кілька систем, а часом і власний продукт. AI імітує простоту: перший результат з'являється швидко, а справжній обсяг роботи лишається за кадром.
Цей обсяг ховається на останньому відрізку: зібрати контекст, вбудувати AI в процес, перевіряти результат, привчити команду. Саме тут проєкти й зупиняються, на півдорозі, з десятком напівготових ідей.
Ми бачимо це у власній роботі щодня. Довести AI-проєкт до кінця можна, але для цього потрібна система, на яку спирається кожен наступний крок.
Як зробити так, щоб AI-проєкт вдався?
Почніть з одного процесу. Запишіть контекст, з яким AI має працювати. До старту домовтесь, що вважати результатом, і перевіряйте кожен результат за цим критерієм. Автоматизуйте лише те, що вже стабільно працює вручну. Так проєкт проходить етапи по черзі, і жоден із них не випадає.
Перед запуском пілоту варто відповісти на п'ять питань:
- Який один процес ми змінюємо і хто за нього відповідає?
- Де записано контекст, з яким працюватиме AI?
- Як ми зрозуміємо, що результат готовий?
- Хто і як перевіряє результат, перш ніж його прийняти?
- Що має працювати вручну, перш ніж ми це автоматизуємо?
Немає відповіді хоча б на одне питання: пілот ризикує стати ще одним гарним демо.
Підсумок
Більшість AI-проєктів провалюються з тих самих причин: команда стрибає до автоматизації, пропускаючи базу знань і перевірку результату. Цифри в дослідженнях різні, а картина одна. Найдешевший спосіб не потрапити в статистику: пройти етапи по черзі.
Щоб зрозуміти, з якого етапу почати, пройдіть короткий тест у статті про модель зрілості AI. А якщо цікаво, як етапи виглядають у живій системі, покажемо за 20 хвилин на дзвінку.
Джерела
- RAND Corporation, "The Root Causes of Failure for Artificial Intelligence Projects and How They Can Succeed", 13.08.2024: https://www.rand.org/pubs/research_reports/RRA2680-1.html
- Gartner, "Gartner Predicts 30% of Generative AI Projects Will Be Abandoned After Proof of Concept By End of 2025", 29.07.2024: https://www.gartner.com/en/newsroom/press-releases/2024-07-29-gartner-predicts-30-percent-of-generative-ai-projects-will-be-abandoned-after-proof-of-concept-by-end-of-2025
- Gartner, "Gartner Predicts Over 40% of Agentic AI Projects Will Be Canceled by End of 2027", 25.06.2025: https://www.gartner.com/en/newsroom/press-releases/2025-06-25-gartner-predicts-over-40-percent-of-agentic-ai-projects-will-be-canceled-by-end-of-2027
- Fortune, on MIT NANDA "The GenAI Divide", 18.08.2025: https://fortune.com/2025/08/18/mit-report-95-percent-generative-ai-pilots-at-companies-failing-cfo/